
AIトレーニングビデオを計画、スクリプト作成、制作する方法を学びましょう。オンボーディング、コンプライアンス、スキル開発のために、撮影や制作予算なしで行えます。
AIトレーニングビデオの作成方法:実践ガイド
従来の方法で単一のトレーニングビデオを制作するには、通常、スクリプト作成、タレントのスケジューリング、撮影、編集、承認ラウンドを含めて、40時間から100時間の作業が必要です。ポリシーが変更されたり、プロセスが更新されたりすると、ビデオは最初から作り直さなければなりません。
AIはその大部分のオーバーヘッドを取り除きます。従来の制作スケジュールに制約されたチームは、現実的に四半期ごとに数モジュールから週に数モジュールに移行できます。制約要因はもはや生産能力ではなく、コンテンツの質と教育的デザインです。
このガイドでは、トレーニングコンテンツを動画用に構成する方法、各トレーニングタイプに適したフォーマット、撮影なしで動画を制作する方法、情報が変更された場合の対処法について、完全なプロセスをカバーしています。
トレーニングビデオが失敗する理由:AIの変化
トレーニングビデオが失敗する最も一般的な理由は、制作品質とは関係ありません。それは長すぎることです。
15分を超える動画の完了率は急激に低下し、トレーニング動画はモジュールごとに3〜7分で最も効果的に機能します。45分の新入社員オリエンテーションは、制作が優れていても魅力的にはなりません。学習者が記憶し、適用できる1つのことをカバーする5つの短いモジュールにする必要があります。
トレーニングビデオが失敗する第二の理由は関連性です。学習者の役割、ツール、またはワークフローを反映しない一般的なコンテンツは、視聴者に対してその素材を自分の仕事に結びつけるための追加の翻訳作業を求めます。その翻訳はほとんど行われません。
AIは両方の問題に対処します。能力のあるAIビデオジェネレーター多くの短く特定の動画を経済的に制作することが可能になります。以前は高価な動画1本と何もないものの間で選択しなければならなかったチームは、今では各役割、各ツール、各プロセスステップのために別々のモジュールを制作し、何かが変わったときにはそれぞれを独立して更新できるようになりました。
トレーニングビデオの種類とそれぞれに適したフォーマット
異なるトレーニング目標には異なるフォーマットが必要です。間違ったフォーマットを選ぶことは、長さを間違えることに次いで一般的な構造的ミスです。
- オンボーディングと文化— プレゼンター主導またはアニメーション — 3〜5分
- ソフトウェアまたはプロセスのウォークスルー— 音声解説付きの画面録画 — タスクごとに2〜4分
- コンプライアンスとポリシー— プレゼンター主導のシナリオ例付き — 2〜4分
- 製品知識— ミックス: プレゼンターと生成された映像 — 3〜6分
- ソフトスキルとコミュニケーション— シナリオベースまたはプレゼンター主導 — 4〜7分
プレゼンター主導のビデオ人をフィーチャーし、撮影されたものまたはAI生成されたもので、コンテンツを直接提供する。プレゼンター主導のビデオは、導入、文化コンテンツ、トーンや関係が情報とともに重要なトピックに適している。
画面録画動画ソフトウェアトレーニングの標準であり、実際に使用されているインターフェースを示しています。映像はスクリーンレコーダーからのものでなければならず、AIがナレーション、フレーミング、そしてその映像の編集を担当します。
生成された映像のビデオテキストから動画を使用するか画像から動画へナレーションの下に視覚的なレイヤーとして出力します。これらは、インターフェースを表示する必要がない場合でも、製品知識、概念的な説明、プロセスの概要に適しており、トピックが視覚的なサポートから利益を得ることができます。
複雑さのあるほとんどのトレーニングビデオは、同じモジュール内で複数のフォーマットを使用します。
AIトレーニングビデオの作成方法:ステップバイステップ
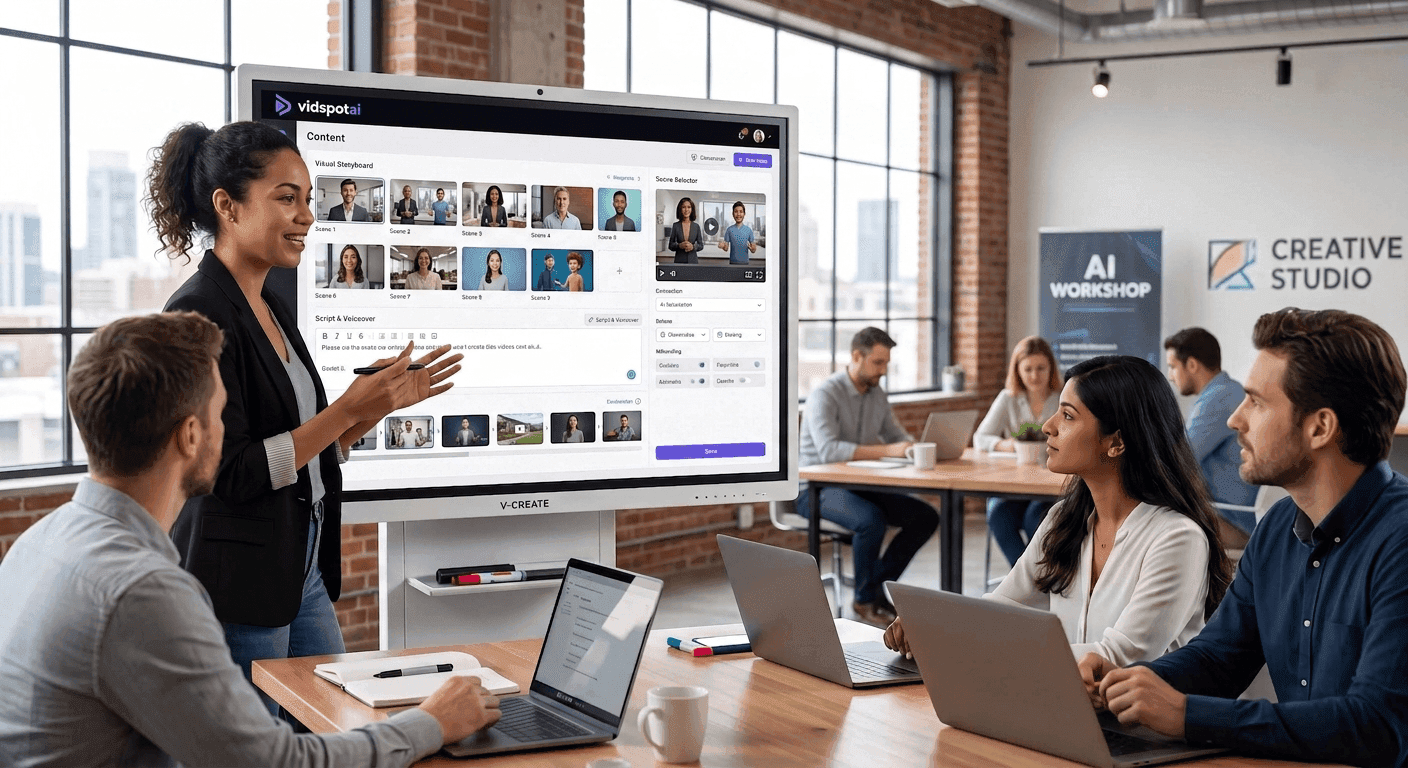
次の6つのステップは、コンテンツデザインから制作、配信までの順序で進みます。ステップ1と2は編集に関するもので、生成ツールが開かれる前に行われます。ステップ3から6は制作をカバーしています。
ステップ1:学習目標を定義する
すべてのトレーニングビデオには、1つの学習目標が必要です。それは、視聴後に視聴者が得る特定の行動、スキル、または知識のことです。
「私たちのコンプライアンス方針を理解する」ではありません。それはトピックです。
「必ず報告が必要な三つの状況を特定し、それぞれに必要なフォームを記入する。」それが目的です。
その区別は重要です。なぜなら、目的がスクリプト、フォーマット、長さ、成功の指標を決定するからです。明確な目的のないビデオは、録画されたプレゼンテーションに過ぎません。
このビデオを視聴した後、視聴者は[specific action]ができるようになります。
- 「フィッシングの試みを特定し、内部チケットシステムを使用して報告してください。」
- 「週次のタイムシートを3分以内に完成させてください。」
- 「管理トレーニングで紹介された三部構成モデルを使用してフィードバックを提供してください。」
1つの動画につき1つの目的。コンテンツに2つの目的が必要な場合は、2つの動画が必要です。
ステップ2:文書ではなく、ビデオ用に構築されたスクリプトを書く
AIトレーニングビデオ制作における最大の誤りは、ポリシー文書やスライドデッキを適応させずにスクリプトに変換することです。文書は読者のために書かれていますが、スクリプトはリスナーのために書かれています。
文書には次のように記載されている場合があります。「従業員は、入社日から30日以内に必須のサイバーセキュリティトレーニングを完了する必要があり、その後は毎年リフレッシャートレーニングが必要です。詳細は従業員ハンドブックの第4.2節に記載されています。」
同じ情報のスクリプト: "あなたは開始日から30日以内にサイバーセキュリティトレーニングを完了する必要があります。その後は年に一度行われます。どちらも必須です。"
リスナーは情報を一度聞き、それを即座に理解する必要があります。正式な表現、入れ子の節、および文書の参照は翻訳されません。
2列形式を使用してください:片側にナレーション、もう片側に視覚的説明。
- ナレーション:「必ず報告が必要な状況は三つあります。」 — ビジュアル:タイトルカード: "報告が必要な3つの状況"
- ナレーション:「最初は、たとえ確信がなくても、疑わしいデータ侵害です。」 — ビジュアル:データ侵害を表すアイコンまたはグラフィック
- ナレーション:「二つ目は、請求に関する顧客からの苦情です。」 — ビジュアル:請求に関する紛争を表すアイコン
- ナレーション:「三つ目は、規制当局からのいかなる要求です。」 — ビジュアル:規制機関を表すアイコン
視覚的な説明は、ビデオを生成する際のプロンプトになります。スクリプト段階で具体的な視覚的説明を書くことで、後の再生成時間を節約できます。
スクリプトの長さ。自然なナレーションのペースで約150語/分の場合、3分のモジュールには約450語のスクリプトが必要で、5分のモジュールは約750語になります。ドラフトを作成する前に目標を知っておくことが重要です。なぜなら、目標なしに書かれたスクリプトはほぼ常に長くなってしまうからです。
ステップ3:生産アプローチを選択する
適切なアプローチは、トレーニングビデオが何を示す必要があるかによって異なります。
プレゼンター主導(撮影は不要)。オンボーディング、コンプライアンス、ソフトスキル、文化コンテンツのために、プレゼンターがスクリプトを視聴者に直接届けます。AIアバターがリップシンクを行うことで、撮影の必要がなくなります。これは、人間の顔が信頼性を構築し、素材がインターフェースや物理的プロセスを示す必要がない場合に機能します。VidSpotAIのProプランには、AIアバターカメラやスタジオの予約なしで、プレゼンター主導のトレーニングスクリプトの配信をサポートするリップシンク機能を備えたジェネレーター。
スクリーンキャプチャと生成された周囲。ソフトウェアトレーニングには、画面上の実際のインターフェースが必要です。その映像はスクリーンレコーダーからのもので、macOSとWindowsの両方に含まれており、ほとんどのチームには好まれるツールがあります。スクリーンキャプチャは証拠を提供します:どのボタンをクリックするか、メニュー項目がどこに表示されるかを正確に示します。AI生成はその周囲のすべてをカバーします:オープニングコンテキスト、学習者がこれから見るものを紹介するプレゼンター、各ステップを説明するナレーション、そして締めくくりの要約です。
完全に生成されました。製品知識、概念的説明、プロセスの概要、そしてグローバルコミュニケーショントレーニングは、しばしばインターフェース映像を必要としません。テキストからビデオへの生成が視覚的な層を作り、スクリプトがナレーションを提供します。これは最も柔軟なアプローチであり、特に多言語コンテンツにおいて、大規模に迅速に制作することができます。
ステップ4:ビデオを生成する
2列のスクリプトと選択したアプローチを用いることで、生成が体系的になります。
モデルをコンテンツに合わせてください。異なる生成モデルは異なる外観を生み出します:フォトリアルなスタイルからイラストスタイル、クリーンなコーポレートビジュアルまで。VidSpotAIは、10のモデルを1つのインターフェースを通じてルーティングします:Veo、Kling、Runway、Luma、Pixverse、Hailuo、Haiper、Seedance、Hunyuan、Midjourney。トレーニングコンテンツにおいては、モジュール全体での視覚的一貫性がフォトリアリズムよりも重要です。モデルを選択し、シリーズ全体でそれを維持してください。
視覚的コラムからのプロンプト。スクリプト内の視覚的な説明がプロンプトです。「請求の争いを表すアイコン」は出発点であり、「顧客サービスのチャットインターフェースを表示した電話の画面のクローズアップ、クリーンな白い背景、プロフェッショナルな照明」は使えるものを生み出します。具体的なプロンプトは、一般的に曖昧なものよりも使える結果を生み出します。
オープニングに再生の努力を費やしてください。最初の10秒は注意を引く上で重要な役割を果たします。完了率は、最初の数秒が注意を引くかどうかに大きく影響されます。中間部分よりも、そこに再生成の試行を多く予算してください。
VidSpotAIは、2分のコンプライアンスモジュールから7分の製品深掘りまで、上記のすべてのフォーマットをカバーする最大10分の動画を生成します。フルトレーニングライブラリを制作するチームのために、AIビデオエージェントProプランでは、スクリプトから自動的にビデオを作成し、手動でシーンを組み立てることなく、完全な初稿を生成します。
ステップ5:ナレーションとキャプションを追加する
AI音声ナレーションは、大規模なトレーニングコンテンツのデフォルトであり、主に迅速な更新を可能にするためです。スクリプトを変更し、ナレーションを再生成すれば、動画は最新のものになります。声のトーンはトレーニングの種類に合わせて調整します。コンプライアンスコンテンツは明確で落ち着いた伝え方が効果的であり、オンボーディングはより温かく、会話的なスタイルが適しています。
多くの企業の学習者は、音声なしで、モバイルデバイスで、共有スペースや通勤中にトレーニングビデオを視聴しています。字幕のないトレーニングビデオは、その視聴者を完全に失ってしまいます。
VidSpotAIは40以上の言語に対応した多言語出力をサポートしているため、1つの言語で制作されたトレーニングビデオは、スクリプト構造を再構築することなく他の市場向けのバージョンを生成できます。トレーニングキャプションでは、他の多くの文脈よりも正確さが重要です。公開前にスクリプトと照らし合わせて確認してください。
ステップ6:レビュー、調整、配布
トレーニングビデオを公開する前に、次の3つのチェックを実行してください:
音を消して動画を確認してください。視覚やキャプションだけでは学習目標が明確でない場合、そのビデオはナレーションに過度に依存している。
すべての手続き的主張を確認してください。ソフトウェアトレーニングでは、各ステップが現在のインターフェースと一致していることを確認してください。コンプライアントトレーニングでは、すべてのポリシー参照が最新であることを確認してください。
セクションの時間を計る。視覚的な変化がない状態で90秒以上続くセグメントがある場合、その修正方法はそれを短い視覚的ビートに分割することです。
VidSpotAIのブラウザベースのAIビデオエディタ, すべてのプランで利用可能で、生成後のシーンレベルの修正を処理します。タイミングがずれたカット、間違ったクリップ、または古いビジュアルは、再構築ではなく修正となります。配信のためには、プラットフォームごとにフォーマット要件が異なるため、制作を最終化する前にエクスポートフォーマットがLMSと互換性があることを確認してください。
トレーニングライブラリを最新の状態に保つ
ビデオ制作のトレーニングにおける最も高い隠れたコストは、初期の制作ではなく、メンテナンスです。
撮影されたコンテンツに基づいて構築されたトレーニングライブラリは、ツールが更新されるたび、ポリシーが変更されるたび、またはプロセスが改訂されるたびに時代遅れになります。各更新には再撮影が必要です:新しいタレントのブッキング、新しい編集、そして新しい承認サイクルが必要です。
AI生成のトレーニングコンテンツは、撮影されたコンテンツよりも更新が容易な場合があります。スクリプトが変更された場合、影響を受けるナレーションとシーンを再生成し、その後再公開します。視覚的一貫性は、同じモデル設定がシリーズ全体で同じスタイルを生み出すため、維持されます。
各トレーニングビデオを完成した作品ではなく、生きた文書として扱ってください。ビデオファイルと一緒にスクリプトを保管します。何かが変更された場合は、まずスクリプトを更新し、その後影響を受けるセクションのみを再生成します。
AIトレーニングビデオ制作における一般的な間違い
AIトレーニングビデオの明確さ、品質、効果に影響を与えるいくつかの一般的な間違いがあります。以下の問題は、最終的なビデオを弱める可能性があります。
リスナーではなく、読者のために書く
ポリシーの言語や技術文書は、ボイスオーバーには翻訳されません。すべての文は、通常の速度で一度聞いたときに機能する必要があります。
モジュールシリーズの代わりに1本の長いビデオ
6つのトピックを扱った20分のトレーニングビデオは、各トピックを1つずつ扱った6つの3分のビデオよりも完了率が低くなるでしょう。計画プロセスの早い段階でコンテンツを短いモジュールに分けてください。
学習目標をスキップする
結果が定義されていない動画はコンテンツであり、トレーニングではありません。トレーニングには、定義された結果と学習を測定する方法が必要です。
一般的なビジュアル
トレーニングコンテンツは具体性から恩恵を受けます:学習者の業界、実際のツール、そしてトレーニングされる実際のインターフェースです。曖昧な生成プロンプトは、他の企業ビデオと交換可能に見える曖昧な映像を生み出します。
キャプションをレビューせずに公開する
自動キャプションは、技術用語、製品名、コンプライアンス用語を頻繁に誤って表示します。公開前にスクリプトと照らし合わせて確認してください。
生成されたドラフトを最終出力として扱う
トレーニングモジュールのオープニングとクロージングは最も重要なセグメントです。オープニングは誰が中身を観るかを決定します。クロージングは学習者が何を持ち帰るかを決定します。両方のために再生時間を予算に入れてください。
よくある質問
AIトレーニングビデオはどのくらいの長さが必要ですか?
職場研修の効果的な範囲は、モジュールごとに3分から7分です。15分を超えると完了率が急激に低下します。長いトピックの場合は、1本の動画の長さを増やすのではなく、コンテンツを一連の短いモジュールに分けてください。
AIは撮影なしでトレーニングビデオを作成できますか?
はい、ほとんどのトレーニングタイプにおいてはそうです。オンボーディング、コンプライアンス、ソフトスキル、製品知識、文化コンテンツは、プレゼンターアバターと生成された映像を使用して完全にAI生成で制作できます。ソフトウェアトレーニングは例外で、インターフェース映像は依然として画面録画から取得する必要があります。なぜなら、AI生成では特定のソフトウェア環境を信頼性高く再現できない可能性があるからです。
プロセスが変更されたとき、トレーニングビデオを最新の状態に保つにはどうすればよいですか?
ビデオと一緒にスクリプトファイルを維持してください。プロセスやポリシーが変更された場合は、スクリプトを更新し、影響を受けるナレーションとシーンのみを再生成します。AI生成のトレーニングコンテンツは、撮影されたコンテンツよりも更新が大幅に速く、再撮影の必要がないためです。
トレーニングビデオは複数の言語で制作できますか?
はい。VidSpotAIは40以上の言語をサポートしているため、1つの言語で作成されたトレーニングモジュールは、視覚構造を再構築することなくローカライズされたバージョンを生成できます。ただし、各バージョンは配布前にナレーションのタイミングとキャプションの正確性を確認するためのレビューが必要です。
トレーニングビデオと説明ビデオの違いは何ですか?
トレーニングビデオには明確な学習目標があり、視聴者が視聴後に特定のスキルや知識を示すことができるかどうかで評価されます。一方、解説ビデオは測定可能な学習成果なしに情報を提供したり説得したりすることが一般的です。制作プロセスは似ていますが、トレーニングコンテンツはより厳密なスクリプトが必要で、通常は評価やフォローアップ活動に関連しています。