
Lär dig hur du planerar, skriver manus och producerar AI-utbildningsvideor för onboarding, efterlevnad och kompetensutveckling, utan filmning eller en produktionsbudget.
Hur man skapar AI-utbildningsvideor: En praktisk guide
Att producera en enda utbildningsvideo på traditionellt sätt tar vanligtvis mellan 40 och 100 timmar av kombinerad insats: manus, schemaläggning av talanger, filmning, redigering och godkännandeomgångar. När en policy ändras eller en process uppdateras måste videon göras om från grunden.
AI tar bort det mesta av den omkostnaden. Ett team som begränsas av traditionella produktionstidsplaner kan realistiskt sett gå från ett fåtal moduler per kvartal till flera per vecka. Den begränsande faktorn är inte längre produktionskapacitet utan innehållskvalitet och pedagogisk design.
Den här guiden täcker hela processen: hur man strukturerar utbildningsinnehåll för video, vilket format som passar varje utbildningstyp, hur man producerar videon utan att filma och vad man ska göra när informationen ändras.
Varför träningsvideor misslyckas: Vilka AI-förändringar
Den vanligaste anledningen till att träningsvideor misslyckas har ingenting att göra med produktionskvalitet. De är långa.
Slutförandefrekvensen sjunker kraftigt för videor över 15 minuter, och utbildningsvideor presterar bäst vid 3 till 7 minuter per modul. En 45-minuters introduktion för nyanställda blir inte engagerande eftersom den är välproducerad. Den behöver bli fem korta moduler, där varje modul täcker en sak som eleven kan komma ihåg och tillämpa.
Den andra anledningen till att utbildningsvideor misslyckas är relevans. Generiskt innehåll som inte återspeglar elevens roll, verktyg eller arbetsflöde ber tittaren att göra extra översättningsarbete för att koppla materialet till sitt jobb. Den översättningen sker sällan.
AI åtgärdar båda problemen. En kapabelAI-videogeneratorgör det ekonomiskt praktiskt att producera många korta, specifika videor. Ett team som tidigare var tvunget att välja mellan en enda dyr video och ingenting kan nu producera en separat modul för varje roll, varje verktyg och varje processteg, och uppdatera var och en oberoende när något ändras.
Typer av träningsvideor och vilket format som passar var och en
Olika träningsmål kräver olika format. Att välja fel format är det näst vanligaste strukturella misstaget efter att ha valt fel längd.
- Onboarding och kultur— Presentatörsledd eller animerad — 3 till 5 minuter
- Genomgång av programvara eller process— Skärminspelning med berättarröst — 2 till 4 minuter per uppgift
- Regelefterlevnad och policy— Presentatörsledd med exempelscenarier — 2 till 4 minuter
- Produktkunskap— Blandat: presentatör plus genererat filmmaterial — 3 till 6 minuter
- Mjuka färdigheter och kommunikation— Scenariobaserat eller presentatörslett — 4 till 7 minuter
Presentatörsledda videorvisar en person, filmad eller AI-genererad, som levererar innehållet direkt. Presentatörsledda videor passar introduktioner, kulturellt innehåll och ämnen där ton och relation spelar roll, tillsammans med information.
Skärminspelningsvideorär standarden för programvaruutbildning och visar det faktiska gränssnittet som används. Filmmaterialet måste komma från en skärminspelare; AI hanterar berättarröst, inramning och redigering kring materialet.
Genererade filmklippanvänd text-till-video ellerbild-till-videoutdata som det visuella lagret under berättarröst. De passar för produktkunskap, konceptuella förklaringar och processöversikter där det inte finns något gränssnitt att visa, men ämnet gynnas av visuellt stöd.
De flesta utbildningsvideor av någon komplexitet använder mer än ett format inom samma modul.
Hur man skapar AI-utbildningsvideor: Steg för steg
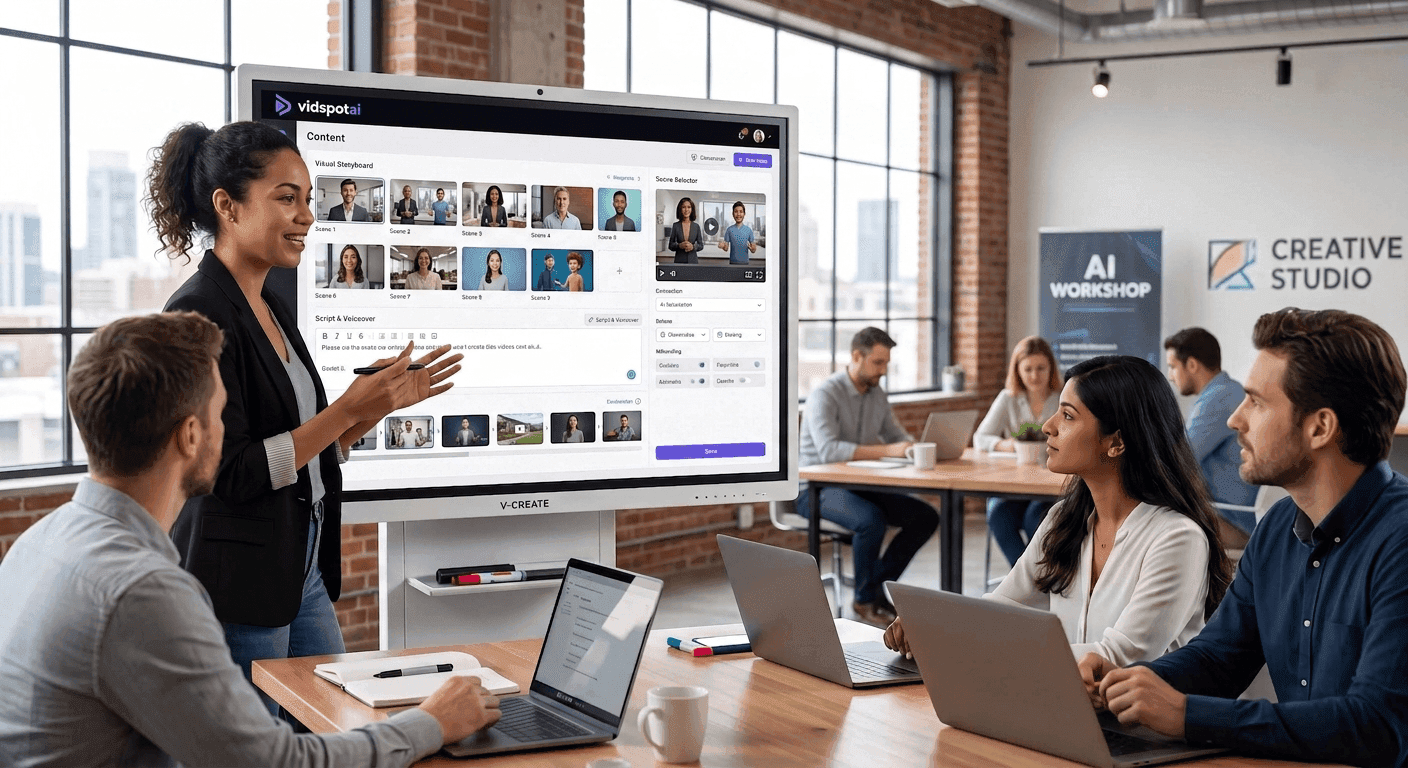
Följande sex steg går i ordning från innehållsdesign till produktion och distribution. Steg 1 och 2 är redaktionella och sker innan något genereringsverktyg öppnas. Steg 3 till 6 täcker produktion.
Steg 1: Definiera lärandemålet
Varje träningsvideo bör ha ett lärandemål: ett specifikt beteende, en färdighet eller en kunskapsdel som tittaren kommer att få efter att ha sett den.
Inte "förstå vår efterlevnadspolicy." Det är ett ämne.
"Identifiera de tre situationer som kräver en obligatorisk rapport och vilket formulär som ska fyllas i för varje situation." Det är ett mål.
Skillnaden är viktig eftersom målet avgör manuset, formatet, längden och framgångsmåttet. En video utan ett definierat mål är en presentation som råkar spelas in.
Skriv målet som ett mätbart resultat. Använd formatet: "Efter att ha sett den här videon kommer tittaren att kunna [specifik åtgärd]."
- "Identifiera nätfiskeförsök och rapportera dem med hjälp av det interna ärendesystemet."
- "Fyll i veckorapporten på under tre minuter."
- "Ge feedback med hjälp av den tredelade modellen som introducerades i ledarskapsutbildningen."
Ett mål per video. Om innehållet kräver två mål, kräver det två videor.
Steg 2: Skriv ett manus byggt för video, inte dokument
Det enskilt största misstaget vid produktion av AI-utbildningsvideor är att konvertera ett policydokument eller en bildserie till ett manus utan anpassning. Dokument skrivs för läsare. Manus skrivs för lyssnare.
Ett dokument kan lyda: "Anställda är skyldiga att genomföra obligatorisk cybersäkerhetsutbildning inom 30 dagar från startdatumet, med repetitionsutbildning som krävs årligen därefter, enligt beskrivningen i avsnitt 4.2 i medarbetarhandboken."
Ett manus för samma information: "Du har 30 dagar från ditt startdatum på dig att slutföra cybersäkerhetsutbildningen. Därefter kommer den en gång om året. Båda är obligatoriska."
Lyssnaren hör informationen en gång och behöver förstå den omedelbart. Formellt register, kapslade satser och dokumentreferenser översätts inte.
Använd ett format med två kolumner: berättarröst på ena sidan, visuell beskrivning på den andra.
- Berättande:"Det finns tre situationer som alltid kräver en obligatorisk rapport."Visuell:Titelkort: "3 situationer som kräver en rapport"
- Berättande:"Det första är alla misstänkta dataintrång, även om du inte är säker."Visuell:Ikon eller grafik som representerar ett dataintrång
- Berättande:"Det andra är ett klagomål från en kund om fakturering."Visuell:Ikon som representerar en faktureringstvist
- Berättande:"Det tredje är alla begäranden från en tillsynsmyndighet."Visuell:Ikon som representerar ett tillsynsorgan
Den visuella beskrivningen blir genereringsuppmaningen vid produktion av videon. Att skriva specifika visuella beskrivningar i manusstadiet sparar tid för regenerering senare.
Manuslängd.Vid en naturlig berättartakt på cirka 150 ord per minut kräver en 3-minutersmodul ungefär 450 ord manus, och en 5-minutersmodul sträcker sig över cirka 750 ord. Känn till målet innan du skriver ett utkast, eftersom manus skrivna utan mål nästan alltid blir långa.
Steg 3: Välj din produktionsmetod
Rätt tillvägagångssätt beror på vad träningsvideon behöver visa.
Presentatörsledd (ingen filmning krävs).För onboarding, compliance, mjuka färdigheter och kulturellt innehåll levererar en presentatör manuset direkt till tittaren. AI-avatarer med läppsynkronisering ersätter behovet av filmning. Detta fungerar när ett mänskligt ansikte bygger trovärdighet, och materialet inte kräver att ett gränssnitt eller en fysisk process visas. VidSpotAIs Pro-plan inkluderar enAI-avatargenerator med läppsynkronisering, som stöder presentatörsledd leverans av alla utbildningsmanus utan kamera- eller studiobokning.
Skärmdump plus genererad omgivning.Programvaruutbildning kräver själva gränssnittet på skärmen. Det materialet kommer från en skärminspelare; både macOS och Windows har en sådan, och de flesta team har ett föredraget verktyg. Skärmdumpar hanterar beviset: de visar exakt vilken knapp man ska klicka på och var menyalternativet visas. AI-generering täcker allt runt omkring: den inledande kontexten, presentatören som presenterar vad eleven ska se, berättarröst som förklarar varje steg och den avslutande sammanfattningen.
Fullständigt genererad.Produktkunskap, konceptuella förklaringar, processöversikter och global kommunikationsträning kräver ofta inga gränssnittsbilder. Text-till-videogenerering skapar det visuella lagret; manuset står för berättarröstningen. Detta är den mest flexibla metoden och den snabbaste att producera i stor skala, särskilt för flerspråkigt innehåll.
Steg 4: Generera videon
Med ett tvåkolumnsskript och en vald metod blir genereringen systematisk.
Matcha modellen med innehållet.Olika generationsmodeller producerar olika utseenden: från fotorealistiska och illustrerade stilar till rena företagsvisuella element. VidSpotAI skickar tio modeller genom ett gränssnitt: Veo, Kling, Runway, Luma, Pixverse, Hailuo, Haiper, Seedance, Hunyuan och Midjourney. För utbildningsinnehåll är visuell konsistens över en modul viktigare än fotorealism. Välj en modell och håll dig till den genom en serie.
Uppmaning från den visuella kolumnen.Den visuella beskrivningen i skriptet är själva prompten. ”Ikon som representerar en fakturatvist” är en utgångspunkt; ”en närbild av en telefonskärm som visar ett kundtjänstchattgränssnitt, en ren vit bakgrund och professionell belysning” ger något användbart. Specifika prompter ger i allmänhet mer användbara resultat än vaga.
Lägg ner regenereringskraft på öppningen.De första 10 sekunderna spelar en viktig roll för att hålla uppmärksamheten uppe. Slutförandegraden påverkas starkt av huruvida de första sekunderna håller uppmärksamheten uppe. Budgetera fler regenereringsförsök där än för de mellersta delarna.
VidSpotAI genererar videor på upp till 10 minuter, vilket täcker alla ovanstående format, från en 2-minuters efterlevnadsmodul till en 7-minuters djupdykning i produkten. För team som producerar ett komplett utbildningsbibliotek,AI-videoagentI Pro-planen hanteras autonom videoskapande från ett manus, vilket producerar ett komplett första utkast utan manuell scenmontering.
Steg 5: Lägg till berättarröst och bildtexter
AI-röstöversättning är standard för utbildningsinnehåll i stor skala, främst för att det möjliggör snabba uppdateringar: ändra manus, generera återberättelsen och videon är aktuell. Matcha rösttonen med utbildningstypen: innehållet i efterlevnadsreglerna gynnas av en tydlig och avvägd leverans; introduktionen kan vara varmare och mer samtalsliknande.
Många företagselever tittar på utbildningsvideor utan ljud, på mobilen, i delade utrymmen eller under pendling. Utbildningsvideor utan textning förlorar dessa tittare helt.
VidSpotAI stöder flerspråkig utdata på över 40 språk, så en utbildningsvideo producerad på ett språk kan generera versioner för andra marknader utan att manusstrukturen behöver rekonstrueras. Noggrannhet är viktigare i utbildningstexter än i de flesta andra sammanhang; granska mot manuset innan publicering.
Steg 6: Granska, justera och distribuera
Kör dessa tre kontroller innan du publicerar en instruktionsvideo:
Kolla videon med ljudet avstängt.Om lärandemålet inte framgår tydligt enbart utifrån bilder och bildtexter är videon alltför beroende av berättarröst.
Kontrollera varje processuellt anspråk.För programvaruutbildning, bekräfta att varje steg matchar det aktuella gränssnittet. För efterlevnadsutbildning, bekräfta att varje policyreferens är aktuell.
Ta tid på sektionerna.Om ett segment körs i mer än 90 sekunder utan en visuell förändring är lösningen att dela upp det i kortare visuella slag.
VidSpotAIs webbläsarbaseradeAI-videoredigerare, tillgängligt på alla abonnemang, hanterar korrigeringar på scennivå efter generering. En felaktigt tidsinställd klippning, ett felaktigt klipp eller en föråldrad visuell version blir en korrigering snarare än en ombyggnad. För distribution, bekräfta att exportformatet är kompatibelt med lärplattformen innan produktionen slutförs, eftersom formatkraven varierar beroende på plattform.
Hålla utbildningsbiblioteken aktuella
Den högsta dolda kostnaden vid produktion av utbildningsvideor är inte den initiala skapandet. Det är underhåll.
Ett utbildningsbibliotek byggt på filmat innehåll blir föråldrat varje gång ett verktyg uppdateras, en policy ändras eller en process revideras. Varje uppdatering kräver en ominspelning: ny talangbokning, ny redigering och en ny godkännandecykel.
AI-genererat utbildningsinnehåll kan vara enklare att uppdatera än filmat innehåll. När ett manus ändras, generera om den berörda berättarröstningen och scenerna och publicera sedan om. Visuell konsistens bibehålls eftersom samma modellinställningar producerar samma stil i en serie.
Behandla varje utbildningsvideo som ett levande dokument snarare än en färdig artefakt. Spara skriptet bredvid videofilen. När något ändras, uppdatera skriptet först och generera sedan bara de berörda avsnitten.
Vanliga misstag i produktion av AI-utbildningsvideor
Flera vanliga misstag kan påverka tydligheten, kvaliteten och effektiviteten hos AI-utbildningsvideor. Följande problem kan försvaga den slutliga videon.
Att skriva för läsare snarare än lyssnare
Policyspråk och teknisk dokumentation kan inte översättas till berättarröst. Varje mening måste fungera när den hörs en gång i normalt tempo.
En lång video istället för en modulserie
En 20-minuters utbildningsvideo som täcker sex ämnen kommer att ha lägre slutförandegrad än sex 3-minutersvideor som vardera täcker ett ämne. Dela upp innehållet i kortare moduler tidigt i planeringsprocessen.
Att hoppa över lärandemålet
En video utan ett definierat resultat är innehåll, inte utbildning. Utbildning kräver ett definierat resultat och ett sätt att mäta lärande.
Generiska bilder
Utbildningsinnehållet gynnas av specificitet: elevens bransch, deras faktiska verktyg och det verkliga gränssnittet som tränas på. Vaga genereringsuppmaningar producerar vaga bilder som ser utbytbara ut med vilken annan företagsvideo som helst.
Publicera utan att granska textning
Automatiska texter missbrukar regelbundet tekniska termer, produktnamn och efterlevnadsspråk. Granska mot manuset innan publicering.
Behandla det genererade utkastet som slutgiltigt resultat
Öppningen och avslutningen av en utbildningsmodul är de viktigaste segmenten. Öppningen avgör om någon tittar på mitten. Avslutningen avgör vad eleven tar med sig. Budgetera regenereringstid för båda.
Vanliga frågor
Hur lång bör en AI-utbildningsvideo vara?
Det effektiva intervallet för arbetsplatsbaserad utbildning är 3 till 7 minuter per modul. Slutförandegraden sjunker kraftigt över 15 minuter. För längre ämnen, dela upp innehållet i en serie korta moduler snarare än att öka längden på en enda video.
Kan AI skapa en träningsvideo utan att filma?
Ja, för de flesta utbildningstyper. Innehåll för onboarding, efterlevnad, mjuka färdigheter, produktkunskap och kultur kan produceras helt genom AI-generering med hjälp av presentatörsavatarer och genererat material. Programvaruutbildning är undantaget; gränssnittsmaterial måste fortfarande komma från en skärminspelare, eftersom AI-generering kanske inte på ett tillförlitligt sätt replikerar en specifik programvarumiljö.
Hur håller jag utbildningsvideor aktuella när processer ändras?
Behåll skriptfilen bredvid videon. När en process eller policy ändras, uppdatera skriptet och generera sedan endast den berörda berättarröst och scener. AI-genererat utbildningsinnehåll är betydligt snabbare att uppdatera än filmat innehåll eftersom det inte finns något behov av att filma om.
Kan utbildningsvideor produceras på flera språk?
Ja. VidSpotAI stöder fler än 40 språk, så en utbildningsmodul som produceras på ett språk kan generera lokaliserade versioner utan att den visuella strukturen behöver byggas om. Varje version behöver fortfarande granskas för att bekräfta berättarröstens timing och textningens noggrannhet före distribution.
Vad är skillnaden mellan en instruktionsvideo och en förklarande video?
Utbildningsvideor har ett definierat lärandemål och utvärderas utifrån om tittaren kan visa en specifik färdighet eller kunskap efter att ha sett den. Förklarande videor informerar eller övertygar vanligtvis utan ett mätbart läranderesultat. Produktionsprocessen är likartad, men utbildningsinnehållet kräver mer detaljerat manus och kopplas vanligtvis till en bedömning eller uppföljningsaktivitet.